割合指標の変化要因を可視化するパッケージ TheseusPlot をリリースしました
この記事は R言語 Advent Calendar 2025 の 15日目の記事です。
1. はじめに
データ分析をやっていると、2つのグループ間で指標に差があるときに、その差を引き起こしている要因を調べたい場合があります。例えば、あるオンラインショップの KPI が前年と比べて悪くなった場合を考えます。このとき、性別に対する深掘り分析を行い、KPI が悪化した原因が男性ユーザにあるのか女性ユーザにあるのか、あるいは性別は関係ないのかを調べたい場合があります。
KPI が売上のような量的指標だった場合は簡単です。男性の売上げと女性の売上の、どちらが下がったのかを調べればいいだけです。しかし、KPI がコンバージョン率のような割合指標のときには難しくなります。量的指標の場合とは異なり、男性グループにおける指標の変化と女性グループにおける指標の変化が、それぞれ全体の指標にどれくらい影響を及ぼすのかを単純に計算することができないからです。
この問題に対処するために、テセウスの船に着想を得たアプローチを提案します。このアプローチでは、比較したい2つのグループに対して、一方のグループのサブグループをもう一方のグループの同じサブグループに徐々に置き換えていき、各段階で指標を再計算します。各段階での指標の変化は、各サブグループが全体の指標の差にどの程度影響しているかとして解釈できます。
例えば、2024年には指標が6.2%で、2025年には5.2%に低下したとします。ここでも性別に注目します。2024年のデータセット内の男性データを2025年の男性データに置き換え、指標を再計算します。その結果、指標は0.8%ポイント低下し、5.4%になったとします。この場合、男性グループが全体の指標に及ぼした影響は-0.8%ポイントです。次に、2024年の女性データを2025年の女性データに置き換えます。すると、データセットは完全に2025年のデータとなり、指標は0.2%ポイント低下し、5.2%になります。したがって、女性グループの影響は-0.2%ポイントです。
これを可視化すると次のようになります。

このグラフから、指標の低下は主に男性グループによって引き起こされていることがわかります。このグラフを「テセウスプロット」と名付けました。
TheseusPlot パッケージは、さまざまな属性に対するテセウスプロットを簡単に作成できるパッケージとして開発されました。
2. インストール
TheseusPlot パッケージは CRAN からインストールできます。
install.packages("TheseusPlot")
3. 基本的な使い方
3.1 データの準備
テセウスプロットを作成するには、共通の列をもつ 2つのデータフレームが必要です。
ここでは、nycflights13 パッケージに含まれる 2013年のニューヨーク市のフライトデータを使用します。割合指標として、定刻到着率(到着予定時刻から15分以内に到着したフライトの割合)を考えます。2013年11月と比較して、2013年12月の定刻到着率は大幅に低下しました。テセウスプロットを用いてその原因を調査します。
まず、データフレームに各フライトが定刻通りに到着したかどうかを示す列 on_time を作成します。次に、11月と12月のフライトを別々のデータフレームとして抽出します。定刻到着率は、11月は 82% でしたが、12月は 67% に低下しました。
library(dplyr)
library(nycflights13)

data <- flights |>
  filter(!is.na(arr_delay)) |>
  mutate(on_time = arr_delay <= 15) |>  # 到着予定時刻から15分以内に到着したか
  left_join(airlines, by = "carrier") |>
  mutate(carrier = name) |>  # 航空会社を正式名称にする
  select(year, month, day, origin, dest, carrier, dep_delay, on_time)

data |> head()
#> # A tibble: 6 × 8
#>    year month   day origin dest  carrier                dep_delay on_time
#>   <int> <int> <int> <chr>  <chr> <chr>                      <dbl> <lgl>
#> 1  2013     1     1 EWR    IAH   United Air Lines Inc.          2 FALSE
#> 2  2013     1     1 LGA    IAH   United Air Lines Inc.          4 FALSE
#> 3  2013     1     1 JFK    MIA   American Airlines Inc.         2 FALSE
#> 4  2013     1     1 JFK    BQN   JetBlue Airways               -1 TRUE
#> 5  2013     1     1 LGA    ATL   Delta Air Lines Inc.          -6 TRUE
#> 6  2013     1     1 EWR    ORD   United Air Lines Inc.         -4 FALSE

data_Nov <- data |> filter(month == 11)
data_Dec <- data |> filter(month == 12)

data_Nov |> summarise(on_time_rate = mean(on_time)) |> pull(on_time_rate)
#> [1] 0.8264803
data_Dec |> summarise(on_time_rate = mean(on_time)) |> pull(on_time_rate)
#> [1] 0.6738712
3.2 プロットとテーブル
準備した2つのデータフレームを使って、まずは ship オブジェクトを作成します。この ship オブジェクトは、テセウスプロットを作成するために設計された R6 クラスのインスタンスです。
library(TheseusPlot)

ship <- create_ship(data_Nov, data_Dec, y = on_time, labels = c("November", "December"))
ship オブジェクトの plot メソッドに列名を渡すことで、テセウスプロットを作成できます。例えば、出発空港 (origin) に対するテセウスプロットを作成するには、次のようにします。
ship$plot(origin)
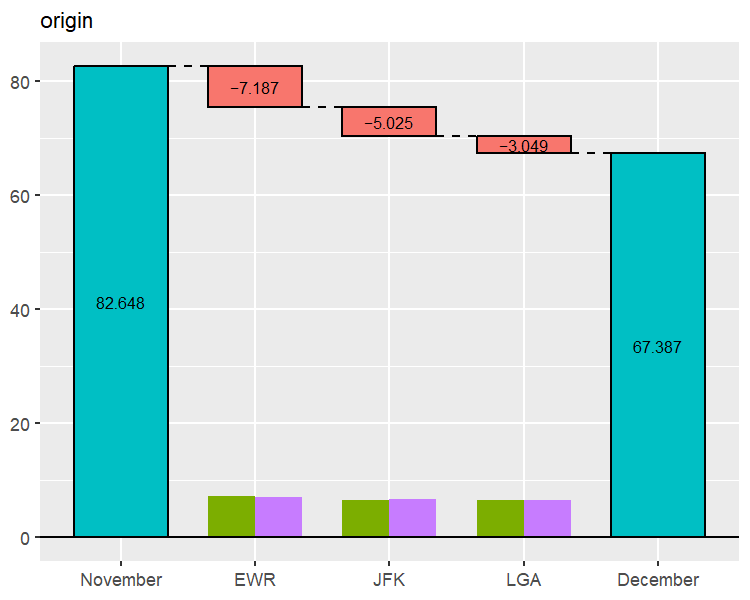
ニューヨーク市には3つの主要空港があり、定時到着率の低下に最も大きく影響したのはニューアーク・リバティー国際空港 (EWR) であることがわかります。
ここで、各出発空港のフライト数は重要です。フライト数が多いほど全体の指標への影響が大きくなることが予想されるためです。そのため、テセウスプロットでは各サブグループ内の各グループのデータサイズを棒グラフで表示します。これにより、各出発空港のフライト数はほぼ同程度であることがわかり、影響を直接比較できることがわかります。
つまり、テセウスプロットは次の 2 つの要素で構成されます。
- 各サブグループが指標の変化にどれくらい影響を与えたかを示すウォーターフォールプロット
- 各サブグループ内の各グループのサンプルサイズを表す棒グラフ
ship オブジェクトは、テセウスプロットで使用される数値をデータフレームで取得するメソッド table も提供します。
ship$table(origin)
#> # A tibble: 3 × 8
#>   origin contrib    n1    n2    x1    x2 rate1 rate2
#>   <chr>    <dbl> <int> <int> <int> <int> <dbl> <dbl>
#> 1 EWR    -0.0719  9603  9410  7995  5910 0.833 0.628
#> 2 JFK    -0.0502  8645  8923  7290  6142 0.843 0.688
#> 3 LGA    -0.0305  8723  8687  7006  6156 0.803 0.709
3.3 プロットの反転
定刻到着率の低下に対する航空会社 (carrier) の影響を調べたいとします。しかし、データ中には航空会社は 16 社含まれるため、通常のテセウスプロットだと文字が重なって見づらくなってしまいます。サブグループが多い場合、plot_flip メソッドを使って x 軸と y 軸を入れ替えることで、見やすくすることができます。
ship$plot_flip(carrier)
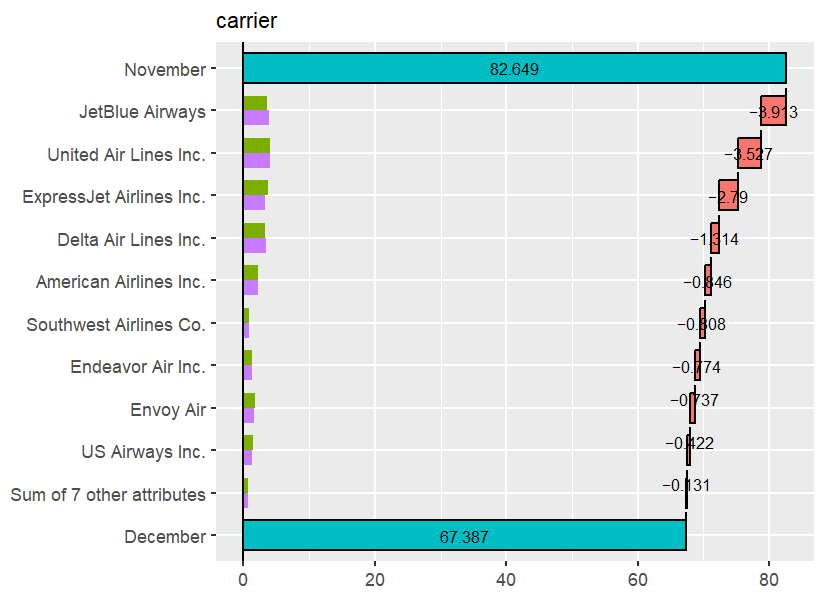
サブグループの数が多い場合、影響の小さいサブグループは自動的に1つにまとめられます。デフォルトでは、サブグループの数が10を超えるとこの処理が行われます。これは引数 n で調整できます。
ship$plot_flip(carrier, n = 6)
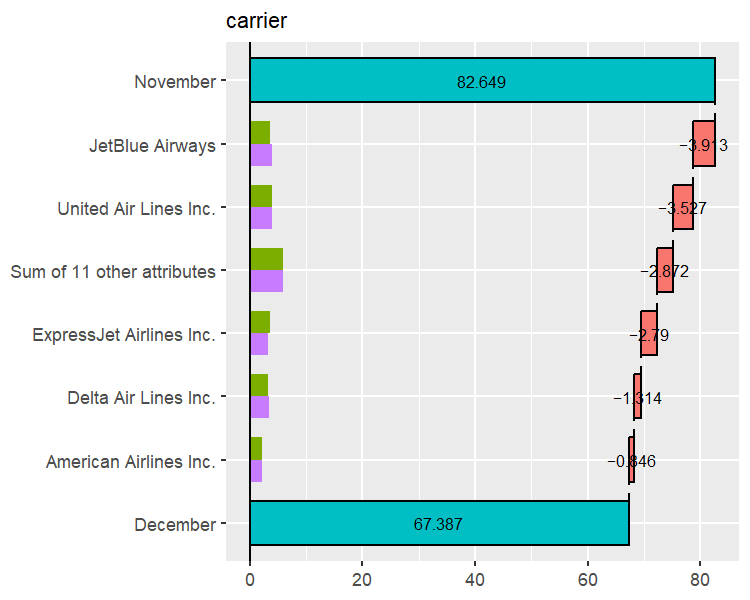
このグラフから、定時到着率の低下に最も大きい影響を与えている航空会社は、JetBlue Airways と United Air Lines であることがわかります。
3.4 連続変数の離散化
テセウスプロットは原理的には連続変数に対して描くことはできません。しかし、割合指標に対する連続変数の影響を調査したいことはよくあります。そこで、ship$plot() メソッドでは、連続値の入った列が指定された場合に、自動的に離散化を行います。例えば、出発が何分遅れたか (dep_delay) に対してテセウスプロットを作成すると次のようになります。
ship$plot_flip(dep_delay)

デフォルトでは、連続変数は、ビンの数が 10 で、各ビンのサンプルサイズがほぼ等しくなるように離散化されます。引数 continuous に continuous_config() を渡すことで、離散化の設定を変更できます。
ship$plot_flip(dep_delay, continuous = continuous_config(n = 3))
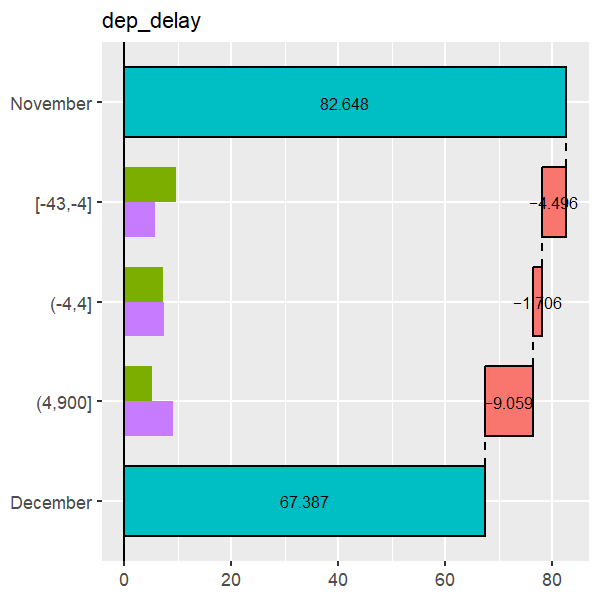
このグラフから結果を読み取るには、サンプルサイズを表わす棒グラフまで注意深く見る必要があります。このグラフは、定刻前に出発したフライトが減少したことと、遅延して出発したフライトが増加したことの両方が、定刻到着率の低下の原因であることを示しています。
4. まとめ
この記事では、割合指標の変化要因を可視化するパッケージ TheseusPlot について紹介しました。より詳しくは公式ドキュメントをご参照ください。このパッケージはリリースしたばかりでまだ使いづらいところが多いかと思います。改善してほしいところや不具合などありましたら、GitHubやこのブログのコメント欄までお気軽にお知らせください。
Enjoy!
補足
サブグループを入れ替える順番で影響度は変わらないの?
ナイーブな方法だと変わります。なので、実際は Shapley 値の近似値を計算して影響度としています。
SHAP とは違うの?
違います。SHAP とは解いている問題が違うので、どちらかがどちらかの代わりになるということはありません。
PDP とは違うの?
PDP は同様の可視化が可能です。PDP と比較して利点と欠点があると考えています。特に、TheseusPlot はモデルを作成する必要がないため、十分な特徴量がない場合にも使えます。
| TheseusPlot | PDP | |
|---|---|---|
| モデルを作成する必要がない | ○ | × |
| 連続変数を直接扱える | × | ○ |
| 出力変数と強く相関した変数が扱える | ○ | × |
デルタ法を使った統計的仮説検定を行うパッケージ deltatest をリリースしました
Web における A/B テストでは、ランダム化単位と分析単位が異なるということがよくあります。 例えば、A か B かのランダム割付がユーザーごとに行われるのに対して、評価指標として分析したいのはページビューごとのクリック率だったりします。 この場合、ランダム化単位はユーザー、分析単位はページビューということになります。
一般に、Web の A/B テストはサンプルサイズが非常に大きいため、中心極限定理により平均値は正規分布に従うと仮定できるので、Z検定がよく使われます。 しかし、ランダム化単位と分析単位が異なると、この Z検定にまずいことが起きます。 具体的には、一人のユーザーが複数のページビューを発生させることができ、それぞれのユーザーは異なるクリック率を持つため、Z検定が仮定する独立同分布 (i.i.d.) に違反してしまいます。
データがこのような性質を持つと、A と B で評価指標に差が無い場合でも、Z検定の p値は小さめに出やすくなります。 (シミュレーションのコードはこの記事の最後にあります)

したがって、A と B に差が無い場合に、誤って有意差があると判定するリスクが高くなってしまいます。
デルタ法を使った統計的仮説検定
この問題に対して、Deng et al. (2018) では、デルタ法を使った解決策を提示しています。 相関のあるデータにおいて、Z検定の p値が小さくなりやすいのは、分散(ひいては標準誤差)が過小推定されることが原因です。 そこで、デルタ法を使って、データ内相関を考慮した形で分散推定式を導出します。 Z検定の分散推定式をこれに置き換えることで、分散の過小推定を防ぐことができます。
今回、この検定手法を簡単に実行できるパッケージ deltatest を CRAN に登録しました。 インストールするには次を実行します。
install.packages("deltatest")
利用するには、ユーザー(ランダム化単位)ごとに評価指標の分子と分母を集計したデータを準備します。
# A tibble: 200 × 4
    user group click pageview
   <int> <chr> <int>    <int>
 1     1 B         7        8
 2     2 A         4        8
 3     3 B         5       11
 4     4 A         3        9
 5     5 A         3       12
 6     6 B         3        9
 7     7 A         6       14
 8     8 A         3        8
 9     9 A         3        9
10    10 A         5       11
# ℹ 190 more rows
このデータに対して、デルタ法を使った Z検定を実行するには、次のようにします。
library(deltatest)

deltatest(data, click / pageview, by = group)
 Two Sample Z-test Using the Delta Method

data:  click/pageview by group
Z = 1.0601, p-value = 0.2891
alternative hypothesis: true difference in means between control and treatment is not equal to 0
95 percent confidence interval:
 -0.02525010  0.08474725
sample estimates:
  mean in control mean in treatment        difference
       0.47876448        0.50851305        0.02974857
この手法を使うと、A と B に差が無い場合、検定の p値は一様分布します。

したがって、A と B に差が無い場合に、有意差を誤って検出するリスク(タイプ I エラー率)を正しい値(有意水準)に抑えることができます。
詳しい使い方については次をご参照ください。
参考
- deltatest: Statistical Hypothesis Testing Using the Delta Method
- Deng, A., Knoblich, U., & Lu, J. (2018). Applying the Delta Method in Metric Analytics: A Practical Guide with Novel Ideas. Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining. doi:10.1145/3219819.3219919
- 確率変数の比の分布における平均と分散をデルタ法で求める - 人間だったら考えて
コード
generate_data <- function(n_user) {
  data <- data.frame()
  for (i in 1:n_user) {
    group <- sample(c("A", "B"), size = 1)
    N <- rpois(1, 9) + 1
    prob <- rnorm(1, mean = 0.5, sd = 0.1)
    if (prob < 0 || prob > 1) next
    click <- rbinom(N, size = 1, prob)
    d <- data.frame(user = i, group, click)
    data <- rbind(data, d)
  }
  data
}

ztest <- function(data) {
  data_A <- subset(data, group == "A")
  data_B <- subset(data, group == "B")

  mean_A <- mean(data_A$click)
  mean_B <- mean(data_B$click)
  diff <- mean_B - mean_A
  se2_A <- var(data_A$click)
  se2_B <- var(data_B$click)
  se <- sqrt(se2_A / nrow(data_A) + se2_B / nrow(data_B))
  z <- diff / se
  p <- 2 * pnorm(-abs(z))
  list(p.value = p)
}

library(mirai)
daemons(0)
daemons(10, seed = 314)
m <- mirai_map(1:10, function(x) {
  p_values <- double(500)
  for (i in 1:500) {
    data <- generate_data(n_user = 200)
    p_value <- ztest(data)$p.value
    p_values[i] <- p_value
  }
  p_values
}, generate_data = generate_data, ztest = ztest)

p_value <- m[.flat]

library(dplyr)
df <- data.frame(p_value) |>
  mutate(range = cut(p_value, breaks = seq(0, 1, by = 0.05))) |>
  group_by(range) |>
  summarise(p = factor(ceiling(max(p_value) * 20) / 20), n = n()) |>
  mutate(prop = n / sum(n))

library(ggplot2)
ggplot(df, aes(p, prop)) +
  geom_col() +
  geom_hline(yintercept = 0.05, color = "red") +
  scale_y_continuous(breaks = seq(0, 1, by = 0.01), minor_breaks = NULL) +
  xlab("p-value") + ylab("proportion")


library(mirai)
daemons(0)
daemons(10, seed = 314)
everywhere(library(dplyr))
everywhere(library(deltatest))
m <- mirai_map(1:10, function(x) {
  p_values <- double(500)
  for (i in 1:500) {
    data <- generate_data(n_user = 200) |>
      group_by(user, group) |>
      summarise(click = sum(click), pageview = n(), .groups = "drop")
    p_value <- deltatest(data, click / pageview, by = group, quiet = TRUE)$p.value
    p_values[i] <- p_value
  }
  p_values
}, generate_data = generate_data, ztest = ztest)

p_value <- m[.flat]

library(dplyr)
df <- data.frame(p_value) |>
  mutate(range = cut(p_value, breaks = seq(0, 1, by = 0.05))) |>
  group_by(range) |>
  summarise(p = factor(ceiling(max(p_value) * 20) / 20), n = n()) |>
  mutate(prop = n / sum(n))

library(ggplot2)
ggplot(df, aes(p, prop)) +
  geom_col() +
  geom_hline(yintercept = 0.05, color = "red") +
  scale_y_continuous(breaks = seq(0, 1, by = 0.01), minor_breaks = NULL, limits = c(0, 0.1)) +
  xlab("p-value") + ylab("proportion")
ロジスティック回帰に最尤推定量が存在するか判定する
引き続きロジスティック回帰について調べている。
前回、ロジスティック回帰の最尤推定量にはバイアスがあることを調べた。
このバイアスは、サンプルサイズが大きい場合は無視できるが、入力変数の数に対してサンプルサイズが小さい場合には無視できないほど大きくなる。
今回はサンプルサイズをさらに小さくすると起こる問題について考える。
前回の最初の例を少しだけ変えて実行してみよう。
この例では、入力変数の数 として、パラメータ 300個の真の値を、最初の 100個は
、次の 100個は
、残りの 100個は
と設定した。
ここまでは同じだが、変更点として、前回はサンプルサイズ
だったのに対して、今回は
で実行する。
n <- 1300
p <- 300

# データの生成
set.seed(314)
x <- rnorm(n * p, mean = 0, sd = sqrt(1/n))
X <- matrix(x, nrow = n, ncol = p)
beta <- matrix(rep(c(10, -10, 0), each = p/3))
prob <- plogis(X %*% beta)
y <- rbinom(n, 1, prob)

# ロジスティック回帰モデルの適用
fit <- glm(y ~ X, family = binomial, control = list(maxit = 50))
警告メッセージ:
glm.fit: 数値的に 0 か 1 である確率が生じました
df <- data.frame(index = seq_len(p), coef = fit$coefficients[-1])
library(ggplot2)
theme_set(theme_bw())

ggplot(df, aes(index, coef)) +
  geom_point(color = "blue") +
  annotate("segment", x = c(1, 101, 201), xend = c(100, 200, 300),
           y = c(10, -10, 0), yend = c(10, -10, 0), size = 1.5) +
  xlab("Index") + ylab("Coefficients (true and fitted)")

実行結果は見てのとおり、推定されたパラメータが 1e+16 (= 1016) などと、とんでもない値になっていることがわかる。 これは最尤推定量のバイアスとは異なる原因で起こっている。
何が起こっているかというと、実は、このデータに対して、ロジスティック回帰モデルには最尤推定量が存在しない。 ロジスティック回帰モデルには最尤推定量が存在しない場合があるのである。 しかし、R言語の最尤推定値を求めるアルゴリズムは、最尤推定量が存在しない場合にも、なんらかの値を返してしまう。
まとめると、入力変数の数に対してサンプルサイズが小さい場合、推定値には2つのケースが存在する。
- 最尤推定量が存在する場合、バイアスのある推定値
- 最尤推定量が存在しない場合、なんの意味もない値
この記事では、この2つのケースを判別する方法、すなわち、ロジスティック回帰に最尤推定量が存在するかどうかを判定する方法を紹介する。
判定材料
ロジスティック回帰に最尤推定量が存在しない場合、パラメータの推定値が異常な値を取るため、すぐにわかるのではないか?と思ってしまうが、そうでもない。
上記の例でサンプルサイズ を変えて推定されたパラメータの最初の100個 (
) がどのような値を取るかを見てみよう。

でだけ、推定値が異常な値を取ることがわかる。
の小さい範囲を拡大してみると、パラメータが大きめに推定されていることがわかるが、これは真の値が 10 であることを知っているため大きいとわかるのであって、真の値を知らない場合はこの推定値が大きいかどうかの判断は難しい。

判定方法
ロジスティック回帰に最尤推定量が存在するかどうかを判定する方法は、40年ほど前に研究された [Albert & Anderson, 1984][Santer & Duffy, 1986]。
文献 [Albert & Anderson, 1984] によれば、観測データが完全分離 (complete separation) または準完全分離 (quasi-complete separation) の場合に限り、最尤推定量は存在しない。
完全分離とは、入力変数が作る空間に、出力変数を完全に分離できる超平面が存在することを言う。
すなわち、入力変数 、出力変数
に対して、
\begin{cases} Xb > 0 & y = 1 \\ Xb < 0 & y = 0 \\ \end{cases}
を満たす が存在することを言う。ここで、
\begin{align} 2y - 1 = \begin{cases} 1 & y = 1 \\ -1 & y = 0 \\ \end{cases} \end{align}
であるので、
\begin{align} Xb \times (2y - 1) > 0 \end{align}
が成り立つ が存在すればよい。
これは、線形計画問題に実行可能解があるかどうかで判定できる。
ROI パッケージを使えば線形計画問題を簡単に解くことができる。
# ROI パッケージで線形計画問題を解く
library(ROI)

A <- cbind(X, 1) * (2 * y - 1)
b <- rep(0.001, n)
c <- rep(1, p + 1)

lp <- ROI::OP(objective = ROI::L_objective(c),
              constraints = ROI::L_constraint(A, rep(">=", n), b),
              bounds = ROI::V_bound(lb = rep(-Inf, p + 1)))
solution <- ROI::ROI_solve(lp)

# 実行可能解 (feasible solution) があれば完全分離可能
status_code <- solution$status$msg[["code"]]
STATUS_CODE_NO_FEASIBLE_SOLUTION_EXISTS <- 4L
STATUS_CODE_SOLUTION_IS_OPTIMAL <- 5L
STATUS_CODE_SOLUTION_IS_UNBOUNDED <- 6L
is_separable <-
  if (status_code == STATUS_CODE_NO_FEASIBLE_SOLUTION_EXISTS) {
    FALSE
  } else if (status_code == STATUS_CODE_SOLUTION_IS_OPTIMAL) {
    TRUE
  } else if (status_code == STATUS_CODE_SOLUTION_IS_UNBOUNDED) {
    TRUE
  }
ここでは簡易的に完全分離を判定する方法を書いたが、完全分離、準完全分離、そしてオーバーラップ(最尤推定量が存在する)のいずれであるかを判別する線形計画問題の定式化が文献 [Santer & Duffy, 1986] に載っているので参照してほしい。
文献 [Konis, 2007] では、より洗練された方法が提案されている。 これを実装したのが detectseparation パッケージである。 このパッケージでは完全分離または準完全分離かどうかを簡単に判定できる。
library(detectseparation)
result <- detect_separation(X, y, family = binomial())
is_separable <- result$outcome
完全分離または準完全分離であれば最尤推定量は存在しないので、これでロジスティック回帰に最尤推定量が存在するかどうかを判定できる。
参考文献
- Albert, Adelin & Anderson, J.A.. (1984). On the Existence of Maximum Likelihood Estimates in Logistic Regression Models.
- Santner, Thomas & Duffy, Diane. (1986). A Note on A. Albert and J. A. Anderson's Conditions for the Existence of Maximum Likelihood Estimates in Logistic Regression Models.
- Konis, K.P. (2007). Linear programming algorithms for detecting separated data in binary logistic regression models.
ロジスティック回帰の最尤推定量にはバイアスがある
ロジスティック回帰について調べている。
ロジスティック回帰モデルのパラメータの最尤推定量は、不偏推定量ではなく、バイアスがある。
例として、サンプルサイズ 、入力変数の数
のときを考える。
パラメータ 300個の真の値を、最初の 100個は
、次の 100個は
、残りの 100個は
に設定して推定してみよう。
n <- 1500
p <- 300

# データの生成
set.seed(314)
x <- rnorm(n * p, mean = 0, sd = sqrt(1/n))
X <- matrix(x, nrow = n, ncol = p)
beta <- matrix(rep(c(10, -10, 0), each = p/3))
prob <- plogis(X %*% beta)
y <- rbinom(n, 1, prob)

# ロジスティック回帰モデルの適用
fit <- glm(y ~ X, family = binomial)

# パラメータの最尤推定値の抽出
df <- data.frame(index = seq_len(p), coef = fit$coefficients[-1])

library(ggplot2)
theme_set(theme_bw())

ggplot(df, aes(index, coef)) +
  geom_point(color = "blue") +
  annotate("segment", x = c(1, 101, 201), xend = c(100, 200, 300),
           y = c(10, -10, 0), yend = c(10, -10, 0), size = 1.5) +
  xlab("Index") + ylab("Coefficients (true and fitted)")

最初の 100個のパラメータは、真の値 よりも大きめに推定されている。
次の 100個のパラメータは、真の値
よりも小さめに推定されている。
最後の 100個のパラメータは真の値 (
) の周りに均等にばらついている。
つまり、ロジスティック回帰のパラメータの最尤推定量には、絶対値を大きめに推定するようなバイアスが乗っている。
最尤推定量には一致性と漸近正規性があるので、サンプルサイズ が十分大きければ、このバイアスは無視できるようになる。
上記の例でサンプルサイズを変えて同じシミュレーションをしてみよう。

入力変数の数 に対して
まで増やせば、最尤推定量のバイアスは無視できるほど小さくなるようだ。
しかし、逆に言うと、入力変数の数に対してサンプルサイズが小さい場合は無視できないほどのバイアスが乗ってしまう。
このバイアスは、統計解析において次の問題を引き起こす。
- 効果量を過大に見積もってしまう
- 出力の確率を極端に見積もってしまう
上記の例はパラメータの真の値が作為的すぎるので、もう少し現実的な例で説明しよう。
真のパラメータ を正規分布
から抽出し、パラメータの真の値と最尤推定値 (MLE) の散布図を描いてみる。
n <- 4000
p <- 800

# データの生成
set.seed(314)
x <- rnorm(n * p, mean = 0, sd = sqrt(1/n))
X <- matrix(x, nrow = n, ncol = p)
beta <- rnorm(p, mean = 3, sd = 4)
prob <- plogis(X %*% beta)
y <- rbinom(n, 1, prob)

# ロジスティック回帰モデルの適用
fit <- glm(y ~ X, family = binomial)

# パラメータの最尤推定値の抽出
df <- data.frame(true = beta, mle = fit$coefficients[-1])

ggplot(df, aes(true, mle)) +
  geom_point(color = "blue") +
  geom_abline(slope = 1, size = 1) +
  xlab("True signal") + ylab("MLE")

黒線は傾き 1 の直線であり、もしバイアスがなければ推定値はこの線の周りに分布するはずである。 しかし、明らかに分布がずれていることから、この例でも最尤推定量にバイアスがあることがわかる。
また、散布図の傾きが大きくなっていることから、絶対値が大きくなる方向にバイアスが乗っていることがわかる。
絶対値が大きくなる方向にバイアスの乗った推定値を、入力変数の効果量として解釈すると、その入力変数は過大評価され、誤った結論を導いてしまう恐れがある。
もう一つの問題は、このようなバイアスの乗った推定値で算出された出力の確率は、極端な値になりやすいということである。
出力 = 1 となる確率をパラメータの推定値から算出してみる。
x <- X %*% beta
pred <- predict(fit, type = "response")

df <- data.frame(x = x, prob = prob, pred = pred, pred2 = pred2)
ggplot(df, aes(x, pred)) +
  geom_point(color = "blue", alpha = 0.1) +
  geom_point(y = prob) +
  scale_x_continuous(breaks = NULL, limits = c(-6, 6)) +
  scale_y_continuous(breaks = 0:5 * 1/5, minor_breaks = NULL) +
  xlab(NULL) + ylab("Probabilities (True and predicted)")
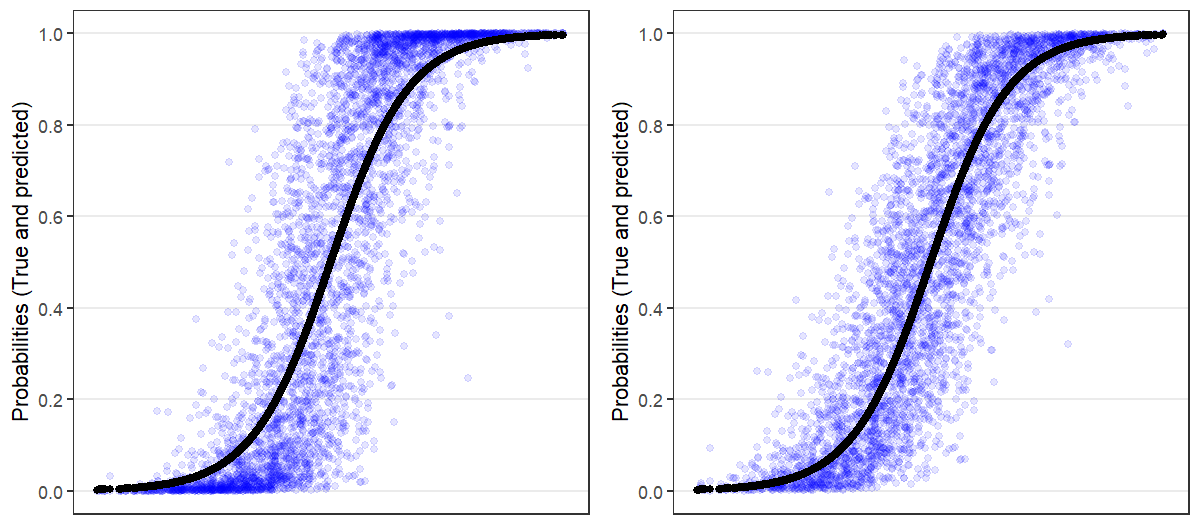
左図はバイアスがある場合、右図はバイアスがない場合である。 黒線が真の確率、青点が予測確率である。
左図は右図にくらべて、予測確率は 0 または 1 に寄っている。 つまり、推定値にバイアスがある場合、予測確率は両極端に偏ってしまう。 この予測確率をもとに「出力はほぼ確実に 1 である」と予測しても、それは推定値のバイアスのせいであって、実際はそれほど確実ではないかもしれない。
続き
ロジスティック回帰モデルの負の対数尤度
ロジスティック回帰モデルの負の対数尤度は次のように書ける。
\begin{align} NLL(\beta) = \sum_{i=1}^n F(x_i \beta) - y_i (x_i \beta) \end{align}
ただし、 はロジスティック関数の積分
\begin{align} F(t) = \int \frac{1}{1 + e^{-t}} dt = \log(1 + e^{t}) \end{align}
である。
導出
- 入力変数
- 出力変数
- 回帰係数
- 逆リンク関数
- モデル
尤度関数
\begin{align} Lik(\beta) = f(x\beta)^{y} (1-f(x\beta))^{(1-y)} \end{align}
とおく
\begin{align} Lik(\beta) = f(t)^{y} (1-f(t))^{(1-y)} \end{align}
対数尤度関数
\begin{align} LogLik(\beta) &= \log(Lik(\beta)) \\ &= \log \left( f(t)^{y} (1-f(t))^{(1-y)} \right) \\ &= \log f(t)^{y} + \log (1-f(t))^{(1-y)} \\ &= y \log f(t) + (1-y) \log (1-f(t)) \\ &= y \log \frac{e^{t}}{1 + e^{t}} + (1-y) \log (1-\frac{e^{t}}{1 + e^{t}}) \\ &= y \log e^{t} - y \log (1 + e^{t}) + (1-y) \log (\frac{1 + e^{t} - e^{t}}{1 + e^{t}}) \\ &= y t - y \log (1 + e^{t}) + (1-y) \log (\frac{1}{1 + e^{t}}) \\ &= y t - y \log (1 + e^{t}) - (1-y) \log (1 + e^{t}) \\ &= y t - y \log (1 + e^{t}) - \log (1 + e^{t}) + y \log (1 + e^{t}) \\ &= y t - \log (1 + e^{t}) \\ \end{align}
負の対数尤度関数
\begin{align} NegLogLik(\beta) &= -LogLik(\beta) \\ &= \log (1 + e^{t}) - y t \\ &= F(t) - y t \\ &= F(x\beta) - y (x\beta) \\ \end{align}
状態を持つループ処理を accumulate() でシンプルに書く
R言語のコミュニティ https://r-wakalang.slack.com で回答したのでメモ。
質問はこんな感じ(意訳しています)。
次のようなデータを以下のルールで処理したい。 データを上から下に見ていき、 (1) before に TRUE が出たら、それ以降は after を TRUE にする。 (2) ただし、condition が FALSE になったら after を FALSE にして状態をリセットする。 これを、for を使わないやり方で書きたい。(データにすでにある after は答えあわせ用)
   before condition after
 1 FALSE  FALSE     FALSE
 2 FALSE  TRUE      FALSE
 3 TRUE   TRUE      TRUE
 4 FALSE  TRUE      TRUE
 5 FALSE  TRUE      TRUE
 6 FALSE  FALSE     FALSE
 7 FALSE  TRUE      FALSE
 8 FALSE  TRUE      FALSE
 9 TRUE   TRUE      TRUE
10 FALSE  TRUE      TRUE
以下、データは次のコードで生成したものを使う(元の質問より簡略化しています)。
library(tidyverse)

# データの準備
d <- tibble(
  before    = c(F,F,T,F,F,F,F,F,T,F),
  condition = c(F,T,T,T,T,F,T,T,T,T),
  after     = c(F,F,T,T,T,F,F,F,T,T),
)
for を使った書き方
これは、状態 (state) を持つ繰り返し処理であり、for を使って書ける。
- データを1行ずつ上から処理する。初期値は before = FALSE, condition = FALSE でこのときの出力 after は FALSE
- 初期状態 (state = 0) で before が TRUE になると after を TRUE にして次の状態 (state = 1) に移る。before が FALSE ならば after は FALSE のままで状態も変わらない
- 次の状態 (state = 1) で condition が FALSE になると after を FALSE にして初期状態に戻る。condition が TRUE ならば after は TRUE のままで状態も変わらない
state <- 0  # 状態を初期化
for (i in seq_len(nrow(d))) {
  row <- d[i, ]  # 一行ずつ取得
  if (state == 0) {
    if (row$before == TRUE) {
      d[i, "after2"] <- TRUE
      state <- 1  # 次の状態に移る
    } else {
      d[i, "after2"] <- FALSE
    }
  } else {  # state == 1
    if (row$condition == FALSE) {
      d[i, "after2"] <- FALSE
      state <- 0  # 初期状態に戻る
    } else {
      d[i, "after2"] <- TRUE
    }
  }
}
結果は d の after2 に格納される。期待する結果である after と一致する。
   before condition after after2
 1 FALSE  FALSE     FALSE FALSE
 2 FALSE  TRUE      FALSE FALSE
 3 TRUE   TRUE      TRUE  TRUE
 4 FALSE  TRUE      TRUE  TRUE
 5 FALSE  TRUE      TRUE  TRUE
 6 FALSE  FALSE     FALSE FALSE
 7 FALSE  TRUE      FALSE FALSE
 8 FALSE  TRUE      FALSE FALSE
 9 TRUE   TRUE      TRUE  TRUE
10 FALSE  TRUE      TRUE  TRUE
accumulate() の使い方
これを for などのループを使わずに書くにはどうすればよいだろうか?
R言語の通常のベクトル化された関数では、状態を持つ処理を行うのは困難である。
そこで、accumulate() 関数を使う。この関数は、ベクトルを1つずつ処理していく関数であり、その際に前の処理の結果を使うことができる(基本関数の Reduce() と同様)。
状態の扱いが問題だったので、状態をいったん出力し、その状態を使って after を求めるという方針を取ろう。 まずは、前の状態を入力にとり、次の状態を結果として返す関数を作成する(上記の for の中身から state に関する部分を抜き出せば簡単にできる)。
compute_state <- function(state, before, condition) {
  if (state == 0) {
    if (before == TRUE) {
      state <- 1
    }
  } else {  # state == 1
    if (condition == FALSE) {
      state <- 0
    }
  }
  state
}
accumulate2() 関数を使って状態を計算するには次のように書く(accumulate() は1変数を受け取り、accumulate2() は2変数を受け取る)。
state_vec <- accumulate2(d$before, d$condition, compute_state, .init = 0)
# 0 0 0 1 1 1 0 0 0 1 1

length(state_vec)
# 11
ただし、得られる結果はデータの行数より1つ多い。これは初期値 (.init = 0) が先頭に含まれるためである。
そのため、現在の状態を得るには最後の値を取り除けばよい。
current_state_vec <- state_vec |> head(-1)
# 0 0 0 1 1 1 0 0 0 1
ちなみに、次の状態を得たい場合は先頭を取り除く。
next_state_vec <- state_vec |> tail(-1)
# 0 0 1 1 1 0 0 0 1 1
accumulate() を使った書き方
現在の状態 state を得ることができた。出力 after は state, before, condition を使って通常のベクトル化された関数で計算できる。
- state が 0 のとき、before が TRUE の場合のみ after = TRUE
- state が 1 のとき、condition が FALSE の場合のみ after = FALSE、すなわち condition が TRUE の場合のみ after = TRUE
d |>
  mutate(state = accumulate2(before, condition, compute_state, .init = 0) |> head(-1)) |>
  mutate(after3 = (state == 0 & before) | (state == 1 & condition))
   before condition after after2 state after3
 1 FALSE  FALSE     FALSE FALSE      0 FALSE
 2 FALSE  TRUE      FALSE FALSE      0 FALSE
 3 TRUE   TRUE      TRUE  TRUE       0 TRUE
 4 FALSE  TRUE      TRUE  TRUE       1 TRUE
 5 FALSE  TRUE      TRUE  TRUE       1 TRUE
 6 FALSE  FALSE     FALSE FALSE      1 FALSE
 7 FALSE  TRUE      FALSE FALSE      0 FALSE
 8 FALSE  TRUE      FALSE FALSE      0 FALSE
 9 TRUE   TRUE      TRUE  TRUE       0 TRUE
10 FALSE  TRUE      TRUE  TRUE       1 TRUE
非常にシンプルに書くことができた。
余談
ここからは余談であるが、この処理はもっとシンプルにできる。
まず、状態を計算する関数 compute_state() は次のように書ける。
compute_state <- function(state, before, condition) {
  if (state == 0) {
    before
  } else {  # state == 1
    condition
  }
}
さらにシンプルにすると次のようになる。
compute_state <- function(state, before, condition) {
  (state == 0 && before) || (state == 1 && condition)
}
これをよく見ると、after3 を計算したときの式と全く同一であることがわかる。
すなわち、今回の問題では、状態の計算結果と出力が一致する。
この場合、状態を計算しなくても、直接出力を計算することができる。
compute_after <- function(after, before, condition) {
  (!after && before) || (after && condition)
}

d |>
  mutate(after4 = accumulate2(before, condition, compute_after, .init = FALSE) |> tail(-1))
   before condition after after2 after4
 1 FALSE  FALSE     FALSE FALSE  FALSE
 2 FALSE  TRUE      FALSE FALSE  FALSE
 3 TRUE   TRUE      TRUE  TRUE   TRUE
 4 FALSE  TRUE      TRUE  TRUE   TRUE
 5 FALSE  TRUE      TRUE  TRUE   TRUE
 6 FALSE  FALSE     FALSE FALSE  FALSE
 7 FALSE  TRUE      FALSE FALSE  FALSE
 8 FALSE  TRUE      FALSE FALSE  FALSE
 9 TRUE   TRUE      TRUE  TRUE   TRUE
10 FALSE  TRUE      TRUE  TRUE   TRUE
Enjoy!
LighitGBM で変数重要度を出すと列名が文字化けするときの解決策
LighitGBM で変数重要度を出すと列名が文字化けするという相談を受けたときの調査メモ。
解決策は3つある。
現象を再現
まずは文字化け現象を再現してみる。データとしてはこんな感じ。
Sys.setlocale(locale = "Japanese_Japan.932")

df_all <- iris
colnames(df_all) <- c("あ", "い", "う", "え", "お")
colnames(df_all)[1] <- iconv(colnames(df_all)[1], from = "SJIS", to = "UTF-8")
head(df_all)
   あ  い  う  え     お
1 5.1 3.5 1.4 0.2 setosa
2 4.9 3.0 1.4 0.2 setosa
3 4.7 3.2 1.3 0.2 setosa
4 4.6 3.1 1.5 0.2 setosa
5 5.0 3.6 1.4 0.2 setosa
6 5.4 3.9 1.7 0.4 setosa
データを表示したときには列名は文字化けしていないのがポイント。
これを LightGBM にかけて変数重要度を出す。
library(lightgbm)

train_data <- as.matrix(df_all[, 1:4])
label <- as.integer(df_all[, 5]) - 1
lgb_train <- lgb.Dataset(data = train_data, label = label)

params <- list(objective = "multiclass",
               num_class = 3,
               metric = "multi_logloss")

model <- lgb.train(params = params, data = lgb_train)

lgb.importance(model)
   Feature       Gain     Cover Frequency
1:  縺<86> 0.62786358 0.3758313 0.3721847
2:  縺<88> 0.33334783 0.2347444 0.2139640
3:  縺<84> 0.02101790 0.2002376 0.2246622
4:  縺<82> 0.01777069 0.1891867 0.1891892
列名 (Feature) が文字化けしてしまっている。
この原因は、列名の文字エンコーディングに UTF-8 と Shift_JIS が混在しているためである。
encoding <- colnames(df_all) |> stringi::stri_enc_detect() |>
  purrr::map_chr(~ .x$Encoding[1])
encoding
[1] "UTF-8" "Shift_JIS" "Shift_JIS" "Shift_JIS" "Shift_JIS"
現実のデータ分析では、データソースの異なるデータを結合して使用することも多いため、このような現象が起こる場合がある。
ひとつでも混じり物があると、すべての列名が文字化けしてしまうというのは興味深い。
解決策1. ロケールを UTF-8 にする
最もおすすめしたい解決策は、ロケールの文字エンコーディングを UTF-8 に変更することだ。 これができるなら一番早い。
Sys.setlocale(locale = "Japanese_Japan.utf8")

lgb.importance(model)
   Feature       Gain     Cover Frequency
1:      う 0.62786358 0.3758313 0.3721847
2:      え 0.33334783 0.2347444 0.2139640
3:      い 0.02101790 0.2002376 0.2246622
4:      あ 0.01777069 0.1891867 0.1891892
しかし、様々な事情があって、これが常に可能とは限らない。
解決策2. 学習時に列名を指定する
2番目におすすめなのは、学習時に列名を指定する方法だ。
lgb.train() 関数には colnames という引数がある。
この引数に文字エンコーディングが統一された列名を入力する。
列名をエディタ上で定義してしまえば文字エンコーディングは自然に統一される。
Sys.setlocale(locale = "Japanese_Japan.932")

col_names <- c("あ", "い", "う", "え")

model <- lgb.train(params = params, data = lgb_train,
                   colnames = col_names)

lgb.importance(model)
   Feature       Gain     Cover Frequency
1:      う 0.62786358 0.3758313 0.3721847
2:      え 0.33334783 0.2347444 0.2139640
3:      い 0.02101790 0.2002376 0.2246622
4:      あ 0.01777069 0.1891867 0.1891892
この方法のデメリットは、列数が多いときになかなか面倒なことである。
解決策3. 列名の文字エンコーディングを統一する
最もおすすめしない解決策は、列名の文字エンコーディングを統一する方法だ。
まずは、それぞれの列名の文字エンコーディングを調べる。
colnames(df_all) |> stringi::stri_enc_detect() |>
  purrr::set_names(colnames(df_all)) |> head(4)
$あ
  Encoding Language Confidence
1    UTF-8                 0.8

$い
   Encoding Language Confidence
1 Shift_JIS       ja        0.1
2   GB18030       zh        0.1
3      Big5       zh        0.1

$う
   Encoding Language Confidence
1 Shift_JIS       ja        0.1
2   GB18030       zh        0.1
3      Big5       zh        0.1

$え
   Encoding Language Confidence
1 Shift_JIS       ja        0.1
2   GB18030       zh        0.1
3      Big5       zh        0.1
1番目の列名「あ」が UTF-8 であるのが文字化けの原因なので、これを Shift_JIS に変換すればよい。
Sys.setlocale(locale = "Japanese_Japan.932")

colnames(df_all)[1] <- iconv(colnames(df_all)[1], from = "UTF-8", to = "SJIS")

model <- lgb.train(params = params, data = lgb_train)

lgb.importance(model)
   Feature       Gain     Cover Frequency
1:      う 0.62786358 0.3758313 0.3721847
2:      え 0.33334783 0.2347444 0.2139640
3:      い 0.02101790 0.2002376 0.2246622
4:      あ 0.01777069 0.1891867 0.1891892
一見するとスマートな方法に思える。
しかし、列名の文字エンコーディングを見抜くのは割と難しい。 ちょっとしたクイズを出してみよう。 次の列名のうち、文字エンコーディングが異なるのは何番目だろうか?
colnames(df_all) |> stringi::stri_enc_detect() |>
  purrr::set_names(colnames(df_all))
$スペード
      Encoding Language Confidence
1 windows-1252       es       0.42
2     UTF-16BE                0.10
3     UTF-16LE                0.10
4    Shift_JIS       ja       0.10
5      GB18030       zh       0.10
6         Big5       zh       0.10

$ハート
   Encoding Language Confidence
1  UTF-16BE                 0.1
2  UTF-16LE                 0.1
3 Shift_JIS       ja        0.1
4   GB18030       zh        0.1
5      Big5       zh        0.1

$ダイヤ
   Encoding Language Confidence
1     UTF-8                 0.8
2  UTF-16BE                 0.1
3  UTF-16LE                 0.1
4 Shift_JIS       ja        0.1
5   GB18030       zh        0.1

$クラブ
   Encoding Language Confidence
1  UTF-16BE                 0.1
2  UTF-16LE                 0.1
3 Shift_JIS       ja        0.1
4   GB18030       zh        0.1
5      Big5       zh        0.1

$ジョーカー
      Encoding Language Confidence
1 windows-1250       pl        0.5
2     UTF-16BE                 0.1
3     UTF-16LE                 0.1
4    Shift_JIS       ja        0.1
5      GB18030       zh        0.1
6       EUC-JP       ja        0.1
7       EUC-KR       ko        0.1
8         Big5       zh        0.1
正解は3番目の「ダイヤ」である。このデータは次のコードで作成した。
df_all <- iris
colnames(df_all) <- c("スペード", "ハート", "ダイヤ", "クラブ", "ジョーカー")
colnames(df_all)[3] <- iconv(colnames(df_all)[3], from = "SJIS", to = "UTF-8")
head(df_all)
  スペード ハート ダイヤ クラブ ジョーカー
1      5.1    3.5    1.4    0.2     setosa
2      4.9    3.0    1.4    0.2     setosa
3      4.7    3.2    1.3    0.2     setosa
4      4.6    3.1    1.5    0.2     setosa
5      5.0    3.6    1.4    0.2     setosa
6      5.4    3.9    1.7    0.4     setosa
このクイズが解けた人でも、現実のデータのぐちゃぐちゃな文字エンコーディングを見ると腰が引けるだろう。
また、最初に見たように、「ひとつでも異なる文字エンコーディングが混在していると、すべての列名が文字化けする」というのも、この方法での解決を困難にする。
おわりに
LighitGBM で変数重要度を出すと列名が文字化けするときの解決策を3つ紹介した。
ここまで読んでくれた人に、ハドリー・ウイッカムの次の言葉を送ろう。
Why are you using SJIS ?
https://github.com/tidyverse/dplyr/issues/339#issuecomment-38159109
参考文献
Rにおける文字列処理について詳しく書かれている(第8章)

